Un directorio no es una copia plana de identidades
Una organización suele describir su directorio como «la lista de usuarios». Esa frase oculta tres problemas distintos. Primero, el directorio tiene una estructura de nombres y atributos que debe poder consultar y modificar un protocolo. Segundo, una operación autenticada no demuestra que el actor tenga permiso sobre cada entrada ni que el cambio haya llegado a todos los consumidores. Tercero, cuando dos sistemas mantienen identidades relacionadas, una sincronización puede retrasarse, repetirse, entrar en conflicto o completar sólo una parte del ciclo de vida.
Este capítulo trata Lightweight Directory Access Protocol (LDAP) como protocolo y como modelo de acceso a un directorio. Después usa ese modelo para razonar sobre sincronización de identidad: el proceso que lee estado de una fuente, transforma o valida atributos y lo materializa en otro sistema. La sincronización no es una flecha mágica ni convierte automáticamente al destino en una copia autoritativa.
La pregunta conductora es: «¿qué estado observó cada sistema, qué operación lo produjo y qué evidencia permite afirmar que una identidad quedó sincronizada?». La respuesta exige separar nombre, identidad, atributo, autorización, transporte, estado de cursor, conflicto y resultado del consumidor.
Antes de empezar
Debes poder distinguir principal, credencial, sesión y autorización; reconstruir una decisión con sujeto, objeto, operación y política; y leer un cambio distribuido sin asumir que una respuesta aislada representa todo el sistema. El capítulo 37 aporta el vocabulario de identidad y sesión; el 40, el de políticas de autorización; el 43, el contexto de Active Directory Domain Services (AD DS), sus objetos y sus fronteras. El capítulo 42 es recomendable para no confundir una operación LDAP con el intercambio de autenticación de Kerberos.
Hasta las operaciones básicas trabajaremos en N2. Desde filtros complejos, paginación y sincronización incremental el razonamiento pasa a N3: cada conclusión debe declarar fuente, destino, operación, precondiciones, versión de estado y evidencia.
DIT, entradas y schema: primero hay que saber qué se está nombrando
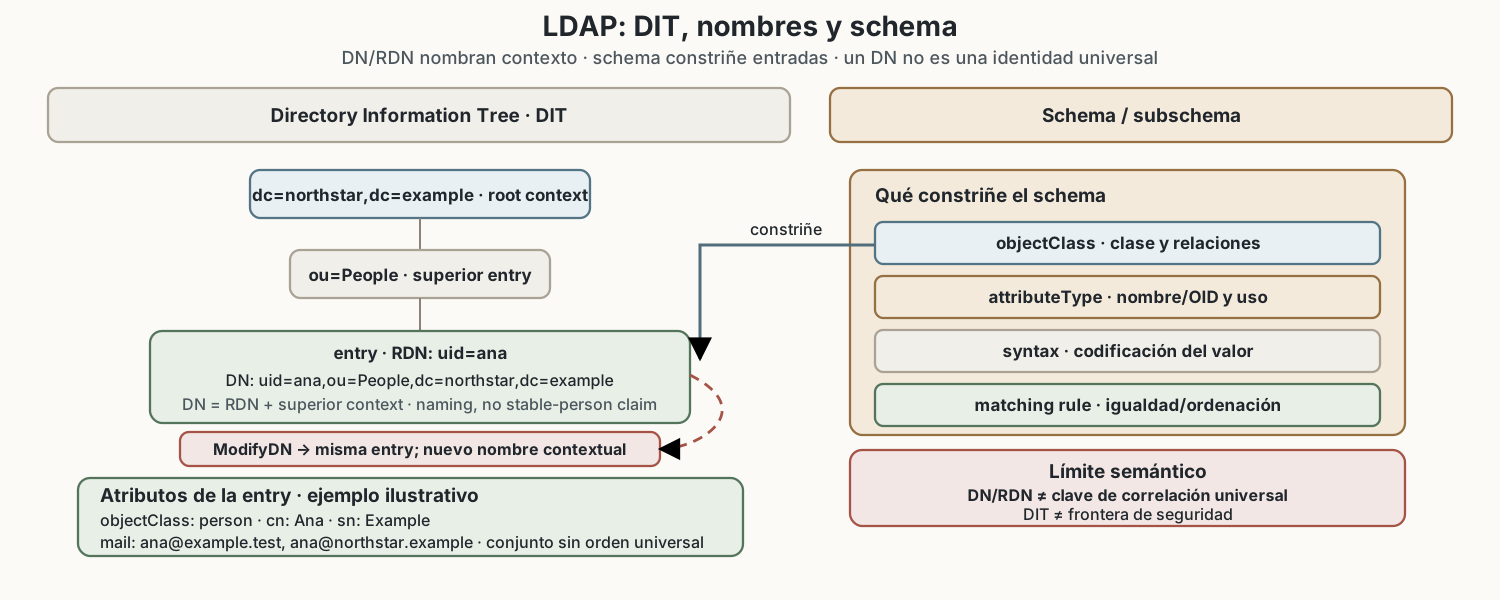
Un directorio LDAP organiza entries en un Directory Information Tree (DIT). Cada entrada tiene un conjunto de atributos y un identificador de posición llamado distinguished name (DN). El DN se construye a partir de componentes relativos; el relative distinguished name (RDN) identifica la entrada respecto de su padre, pero no es necesariamente una identidad de seguridad ni una clave global inmutable.
Un ejemplo sintético puede ser:
uid=ana,ou=finance,dc=northstar,dc=example
Aquí uid=ana es el RDN de la entrada; ou=finance y los componentes dc forman la ruta del árbol. El DN expresa dónde se encuentra la entrada en ese DIT en un momento dado. Un rename puede cambiar el DN sin crear un nuevo principal. En cambio, una aplicación puede usar un identificador inmutable propio, como employeeNumber o un UUID, para correlacionar la identidad entre sistemas. No se debe decidir cuál de esos campos es “la identidad” sin conocer el contrato de la integración.
El schema define qué clases de entrada (objectClass) existen, qué atributos son obligatorios o permitidos y qué sintaxis tienen sus valores. El schema no es un inventario de usuarios: es una restricción sobre la forma de los datos. Una entrada que satisface el schema puede seguir siendo incorrecta para una aplicación si falta un atributo requerido por su contrato, si el valor no está vigente o si la correlación apunta al sujeto equivocado.
La primera pregunta ante un dato es, por tanto, triple: ¿qué entrada se observó?, ¿qué atributo se leyó?, ¿qué identificador usa el consumidor para correlacionarla? Un DN útil para navegar no sustituye un identificador estable, y un identificador estable no prueba que una operación haya sido autorizada.
Desliza horizontalmente para leer el diagrama a tamaño completo.
Nombre, identidad y estado no son sinónimos
Supón que uid=ana cambia a uid=ana.finance. El DN puede cambiar porque cambió el RDN, pero el identificador de correlación podría permanecer. Si la cuenta se elimina y se crea otra con el mismo RDN, el nombre vuelve a coincidir sin que la identidad sea la misma. Un sincronizador que sólo compara el texto del DN puede actualizar el objeto equivocado o crear un duplicado.
También hay que distinguir el estado del directorio del estado que consume una aplicación. La entrada puede mostrar active, el conector puede conservar un watermark antiguo y el SaaS puede seguir usando una membresía anterior en caché. Ninguna de esas observaciones aisladas representa el estado efectivo de la organización.
Sesión LDAP y operaciones: bind no es autorización universal
LDAP define un modelo de mensajes y operaciones. Un cliente establece una sesión con un servidor y puede realizar, entre otras, operaciones Bind, Search, Compare, Add, Modify, ModifyDN, Delete y Unbind. RFC 4511 describe el protocolo y sus operaciones; RFC 4513 acota aspectos de autenticación y seguridad de la capa LDAP. RFC 4511, §4; RFC 4513, §§2–3
Desliza horizontalmente para leer el diagrama a tamaño completo.
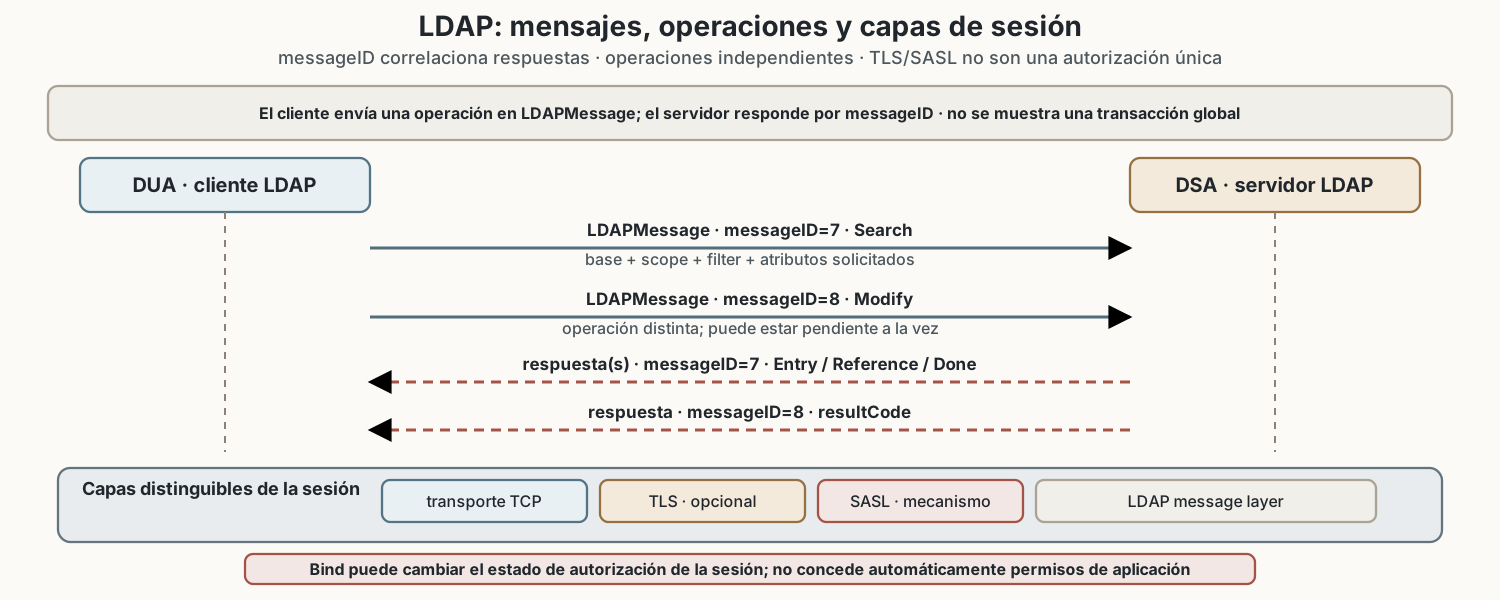
Un Bind cambia o negocia el estado de autenticación de la sesión bajo un mecanismo concreto. El Bind simple comprende el caso anónimo, el no autenticado y name/password; SASL es la alternativa con mecanismos propios. En particular, un Bind simple no autenticado no prueba la identidad que aparece en el campo de nombre. Proteger el canal con Transport Layer Security (TLS) puede aportar confidencialidad e integridad del transporte; no concede por sí mismo permisos para leer o modificar cualquier entrada. SASL puede aportar autenticación y capas de seguridad, pero tampoco reemplaza la política de autorización del servidor.
Después del Bind, la implementación evalúa cada operación según la identidad efectiva, sus mecanismos de autorización —por ejemplo, ACL de producto—, los controles, el alcance y la política local. Un Search que devuelve success no significa que el actor pueda leer todos los atributos del DIT: el resultado puede ser parcial, filtrado o limitado. Un Modify aceptado demuestra que esa operación fue aceptada en ese servidor bajo ese contexto; no demuestra que todas las réplicas o consumidores ya conozcan el cambio.
Desliza horizontalmente para leer el diagrama a tamaño completo.

El caso mínimo es una lectura:
actor: sync-reader
bind: SASL bajo el canal protegido
base: ou=finance,dc=northstar,dc=example
scope: subtree
filter: (&(objectClass=person)(employeeNumber=2048))
attrs: employeeNumber, uid, mail, accountStatus
Para adjudicarla hay que conservar el servidor consultado, el mecanismo de bind, la base, el scope, el filtro, los atributos solicitados, los controles y el resultado. Si el resultado contiene cero entradas, todavía faltan hipótesis: filtro incorrecto, scope demasiado estrecho, réplica atrasada, atributo no visible, entrada eliminada o ausencia real. “No lo encontré” no equivale a “no existe”.
Search, filtros y resultados parciales
El SearchRequest especifica una base, un scope, un filtro y una lista de atributos. El scope puede ser la entrada base, sus hijos directos o el subárbol. Un filtro puede combinar igualdad, presencia, aproximación y relaciones lógicas, pero su sintaxis no convierte la búsqueda en una transacción global. Los límites de tiempo, tamaño, paginación o política del servidor pueden producir una respuesta parcial.
Cuando el cliente usa el control de paginación simple de RFC 2696, la cookie es un valor opaco elegido por el servidor, no una credencial ni un cursor cuyo interior pueda interpretar el cliente. Para pedir la página siguiente deben repetirse los valores de la solicitud inicial salvo messageID, la cookie y, opcionalmente, el tamaño de página. Una cookie vacía indica que no quedan entradas. Si el conjunto cambia después de comenzar la secuencia, una entrada puede repetirse o alguna entrada coincidente puede no aparecer; el control no proporciona una instantánea estable. RFC 2696, §§2–3 Por eso una enumeración de “todos” debe conservar servidor, identidad efectiva, base, scope, filtro, atributos, controles, última cookie y resultado final.
Las referencias (referrals) añaden otra frontera: un servidor puede indicar que parte del espacio de nombres debe resolverse en otro servidor. Seguir una referral puede requerir otra sesión, otra política y otra confianza. La existencia de una ruta de nombres no prueba conectividad, credenciales reutilizables ni permiso para el destino. Un cliente que sigue referrals automáticamente debe registrar el destino y evitar que un valor no confiable se convierta en una conexión arbitraria.
Desliza horizontalmente para leer el diagrama a tamaño completo.

Modify, Add, Delete y ModifyDN
Una modificación tiene actor, entrada objetivo, atributos, operación y resultado. Add puede crear una entrada; Modify puede reemplazar, añadir o eliminar valores; ModifyDN puede renombrar o mover una entrada si el servidor lo permite. El Delete básico de RFC 4511 sólo elimina una entrada hoja: si tiene subordinadas, el servidor debe responder notAllowedOnNonLeaf. Un borrado de subárbol requiere una extensión o una secuencia definida por el producto; no debe atribuirse al LDAP core. Cada operación debe comprobarse frente al schema, permisos, controles y restricciones del servidor.
El resultado también tiene límites. Una respuesta success confirma la operación en el servidor que respondió; no prueba que una aplicación haya recargado sus datos, que un segundo controlador haya convergido ni que el conector haya emitido el evento de salida. Una respuesta de error tampoco identifica automáticamente la causa: puede ser autenticación, autorización, schema, conflicto de unicidad, referral, canal o disponibilidad.
El diseño del cliente debe distinguir reintento seguro de repetición peligrosa. En LDAP, los valores de un atributo forman un conjunto según su sintaxis y matching rule: repetir Modify add con un valor ya presente no crea una segunda copia, sino que debe fallar con attributeOrValueExists. Eso no vuelve idempotente al flujo completo: el destino posterior puede no tener la misma semántica, dos textos pueden representar valores distintos bajo otra normalización y una respuesta perdida deja ambiguo qué efectos asociados terminaron. Un Add reintentado puede devolver entryAlreadyExists aunque el primer intento sí haya creado la entrada. El cliente necesita una lectura de confirmación, versión o clave de evento; no debe ocultar un resultado ambiguo como éxito total. Atributos de producto como memberOf no son un ejemplo LDAP universal: en AD DS suele ser un backlink calculado.
Cinco mecanismos que no deben colapsarse en “la sincronización”
El vocabulario genérico sirve para razonar sobre estados, pero no sustituye el contrato del mecanismo concreto. Esta tabla fija las fronteras:
Desliza horizontalmente para consultar todas las columnas.
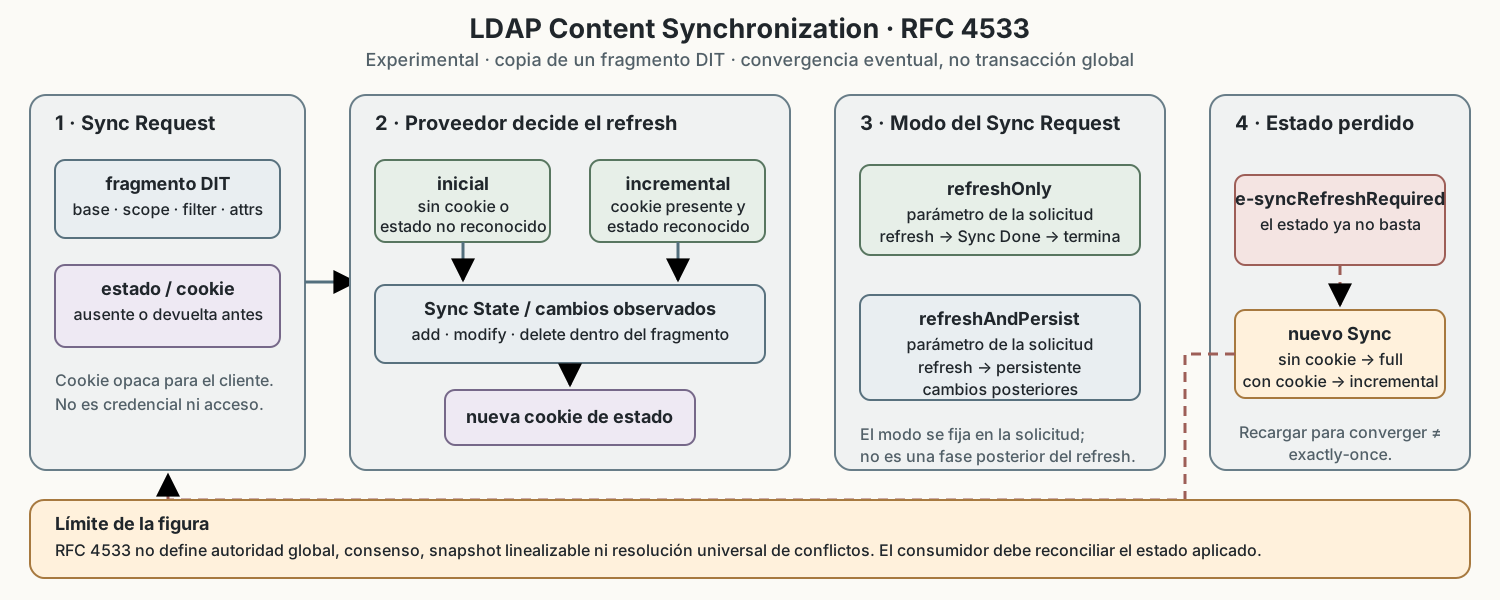
RFC 4533 persigue convergencia eventual de una copia de contenido bajo sus condiciones. Si el proveedor ya no puede continuar desde el estado presentado, syncRefreshRequired obliga a reiniciar la sincronización y puede exigir una recarga. OpenLDAP syncrepl usa ese modelo, pero sus opciones y logs son de producto. En AD DS, DirSync devuelve cambios observables desde una cookie de una partición y uSNChanged es otra estrategia con límites diferentes; la selección del controlador y el estado de replicación importan. Ninguno de esos mecanismos autoriza por sí mismo la operación de negocio del consumidor.
Desliza horizontalmente para leer el diagrama a tamaño completo.
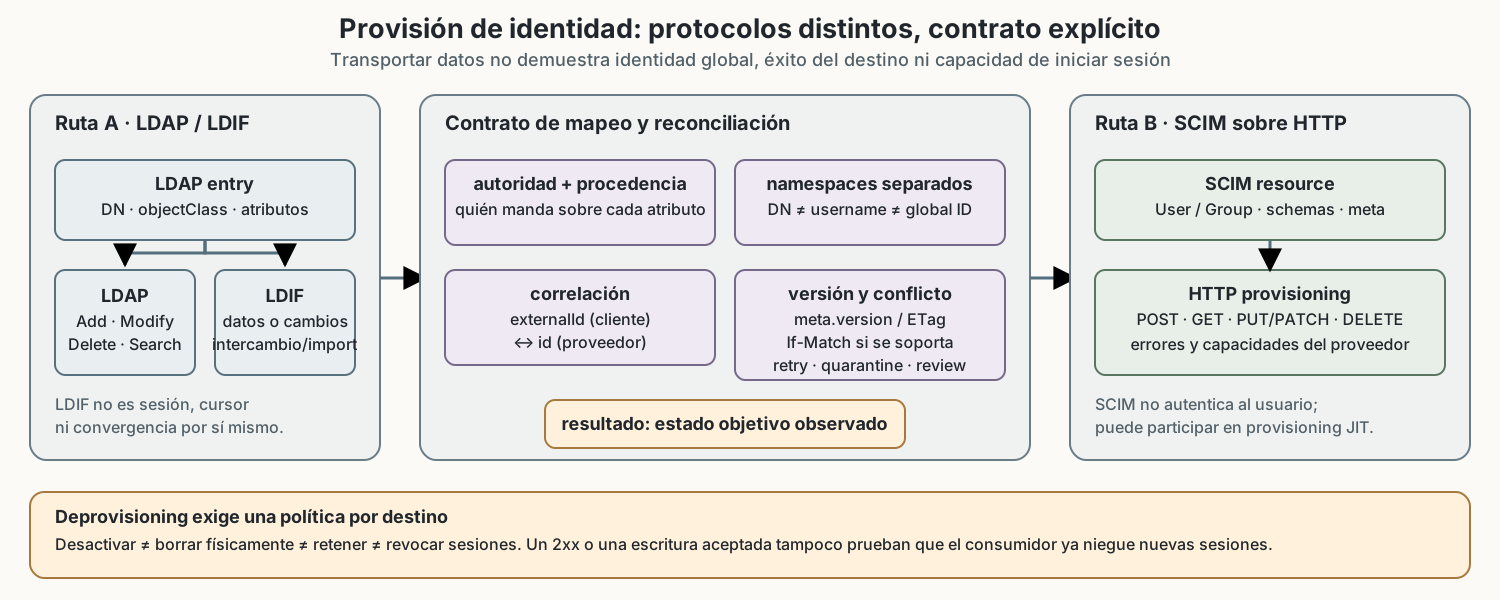
SCIM ocupa otra frontera: crea, consulta, actualiza o elimina recursos de identidad en un service provider. Su id pertenece al proveedor; externalId pertenece al namespace del cliente que aprovisiona. No deben sustituirse uno por otro ni por un DN, email, objectGUID o source anchor sin un mapping explícito. SCIM puede estar protegido por credenciales del cliente de provisioning, pero eso no autentica al usuario final ni crea una sesión. SAML y OpenID Connect, tratados en el capítulo 46, cubren federación/autenticación; gobierno y acceso privilegiado pertenecen al capítulo 48.
Desliza horizontalmente para leer el diagrama a tamaño completo.
De una fuente a un consumidor: sincronizar es ejecutar un proceso de estado
Llamaremos fuente al sistema cuyo estado el diseño decide leer para una relación concreta, destino al sistema que materializa una representación y consumidor al componente que utiliza esa representación para una decisión. “Source of truth” es un alcance del contrato, no una propiedad metafísica: una fuente puede ser autoritativa para employeeNumber y no para mail, roles o estado de cuenta.
Una sincronización inicial suele enumerar objetos, normalizar atributos, correlacionar identidades, crear o actualizar destinos y registrar un checkpoint. Una sincronización incremental lee cambios desde un cursor, número de secuencia, timestamp o watermark. Cada opción tiene límites: un timestamp puede compartir resolución o sufrir cambios de reloj; un cursor puede expirar; una enumeración puede omitir objetos creados durante la ventana; un journal puede retener menos tiempo que el ciclo de recuperación.
El sincronizador debe declarar qué significa “procesado”. Puede significar leído de la fuente, validado, escrito en destino, confirmado por el destino o consumido por la aplicación final. Si esos estados se mezclan, un tablero verde puede ocultar que el usuario existe en la fuente pero no puede iniciar sesión en el consumidor.
Correlación y transformación
La correlación responde a la pregunta: “¿qué entrada del destino representa esta entrada de la fuente?”. Un email puede cambiar, un DN puede moverse, un nombre puede reutilizarse y un identificador externo puede faltar. Una regla robusta prioriza un identificador estable, comprueba unicidad y deja el caso ambiguo en revisión. No debe crear automáticamente una nueva cuenta sólo porque el nombre coincide.
La transformación debe conservar tipos, cardinalidad, normalización y procedencia. Si una fuente entrega accountStatus=disabled y el destino sólo admite active o deleted, hay una decisión de mapeo que debe estar versionada. Si se convierte un grupo en una lista de permisos, el sistema debe registrar qué regla hizo la expansión y qué ocurre cuando el grupo cambia.
La idempotencia es una propiedad del efecto, no del deseo de reintentar. Ejecutar dos veces la misma operación debe producir el mismo estado final bajo el contrato declarado, o el sistema debe detectar la repetición. Una clave de idempotencia no impide por sí sola que dos eventos diferentes tengan el mismo payload; la identidad del evento, la versión de la entrada y la relación fuente-destino también importan.
Reintentos, orden y convergencia
Un conector puede perder la respuesta después de que el destino haya aplicado el cambio. Si reintenta sin leer el estado, puede duplicar una entrada o generar un conflicto. Si descarta el evento porque el cursor avanzó, puede perder una transición. El diseño del conector o flujo debe elegir entre reintentar, consultar, poner en cuarentena y escalar, con límites de tiempo y evidencia.
“Eventual convergence” no significa que todos los sistemas lleguen al mismo valor en todo momento ni que los conflictos se resuelvan solos. Significa que, bajo condiciones declaradas —entrega suficiente, reglas deterministas, ausencia de nuevas escrituras incompatibles—, el estado puede alcanzar un punto común. Un sistema que sólo copia cada cambio en orden de recepción puede converger a la última llegada y no a la última intención válida.
Si existen dos escritores, hay que declarar quién puede cambiar qué atributo, cómo se ordenan las versiones y qué ocurre con una edición concurrente. Un conflicto no es necesariamente un incidente; sí es una condición que exige una política visible. Las opciones pueden ser versionado, prioridad de fuente, revisión humana, combinación por atributo o rechazo seguro. No se debe llamar “last write wins” a una garantía universal: es una elección con supuestos sobre relojes, orden y autoridad.
Ciclo de vida: alta, cambio, suspensión y deprovisioning
Una identidad sincronizada tiene un ciclo de vida, no sólo una fila. En el alta, el sistema debe validar correlación, atributos mínimos, dueño y destino. En un cambio, debe saber si el atributo es fuente de autoridad y si una modificación local será sobrescrita. En la suspensión, debe distinguir impedir un nuevo bind, retirar membresías, invalidar sesiones ya abiertas y detener tareas programadas. En el deprovisioning, debe definir si se borra, se desactiva, se conserva para auditoría o se transfiere la propiedad de sus recursos.
Una baja negativa es tan importante como una alta positiva. No basta con observar que el conector procesó un evento deleted; hay que comprobar que el consumidor ya no acepta el principal, que los grupos derivados se actualizaron, que las sesiones o tokens tienen el comportamiento acordado y que las credenciales o claves no quedan activas en cada destino incluido en el alcance acordado. El cierre debe declarar también qué sistemas quedaron fuera. El mecanismo exacto depende del consumidor y no se hereda automáticamente del directorio.
El peligro de los objetos huérfanos aparece cuando una correlación se rompe: la cuenta desaparece de la fuente, el destino conserva una entrada local y nadie sabe quién la posee. El peligro contrario aparece cuando una recreación reutiliza el mismo nombre y el sincronizador la vincula al objeto anterior sin evidencia de continuidad. En ambos casos conviene conservar identificadores históricos, motivo de la transición, timestamps, operador o proceso y resultado de cada destino.
Diagnosticar divergencia sin inventar una verdad global
Supón que Recursos Humanos marca a ana como suspendida. El directorio fuente muestra disabled; el conector dice “checkpoint al día”; el proveedor SaaS todavía muestra active; una sesión existente sigue consultando un token anterior. Hay varias hipótesis compatibles: el evento no alcanzó el destino, el destino lo aplicó pero el consumidor tiene caché, la correlación apuntó a otra entrada, el conector procesó la lectura pero no la escritura, o la política de suspensión sólo evita nuevos logons.
La investigación debe empezar por una línea temporal y una matriz de estados:
Desliza horizontalmente para consultar todas las columnas.
Una consulta posterior a un servidor no prueba por sí sola que el consumidor haya refrescado. Un log de sincronización que diga success no demuestra que la política de autorización haya cambiado. Un error de Bind tampoco demuestra que la identidad esté suspendida. Hay que conservar el resultCode: invalidCredentials, authMethodNotSupported, strongerAuthRequired, confidentialityRequired, un error de protocolo o la indisponibilidad no significan lo mismo. Los errores de schema como objectClassViolation o constraintViolation corresponden normalmente a operaciones que cambian entradas, no deben usarse como explicación genérica de un Bind fallido. Cada afirmación debe especificar operación, servidor, vista y tiempo.
Sincronización y autorización son fronteras distintas
Un directorio puede entregar atributos a un motor de autorización, pero LDAP no decide automáticamente la política de la aplicación. La aplicación puede usar grupos, atributos o una tabla local; debe declarar qué lee, con qué frecuencia, qué pasa ante ausencia o error y qué evidencia exige. De igual modo, un servidor LDAP puede autenticar un bind y permitir una búsqueda sin que el sujeto tenga permiso para ejecutar una operación de negocio.
AD DS añade objetos, replicación y políticas propias; el capítulo 43 explica esa semántica. OAuth 2.0, en el capítulo 45, trata delegación entre clientes, servidores de autorización y recursos; no es el protocolo que convierte un DIT en una API ni la respuesta a cualquier problema de sincronización. Mantener esas fronteras evita que una cuenta sincronizada, un access token o una referral se conviertan en una explicación universal.
Caso integrado: una baja que no llegó al consumidor
Northstar mantiene empleados en ldap.hr.example y provisiona cuentas en un proveedor de soporte. El contrato de este caso garantiza que employeeNumber es único, persistente durante la vida de la persona y autoritativo en Recursos Humanos; sólo bajo esas precondiciones se usa como identificador de correlación. mail se copia desde Recursos Humanos; el proveedor mantiene además un atributo local supportTier. El conector lee cambios incrementales cada cinco minutos y registra un watermark por partición.
Ana deja la empresa. Recursos Humanos cambia accountStatus a disabled y registra el evento. El conector confirma que leyó el cambio y actualiza el checkpoint, pero su escritura al proveedor falla por un límite de tamaño. En el siguiente ciclo el filtro incremental ya no vuelve a entregar el evento. El proveedor conserva active y Ana puede abrir una sesión de soporte.
La conclusión “LDAP está roto” es demasiado amplia. La observación es que la fuente tiene disabled, el conector avanzó el watermark y el destino conserva active en una versión anterior. La inferencia es que la implementación del conector avanzó el cursor sin vincularlo a un efecto confirmado o a la conservación durable del fallo; no es una propiedad necesaria del protocolo incremental. El impacto posible es una cuenta activa después del deprovisioning esperado; no demuestra que Ana haya accedido a datos sensibles ni que el Bind del directorio haya autorizado esa sesión.
La remediación debe cortar la causa sin bloquear indefinidamente una partición por un evento venenoso. Antes de avanzar el checkpoint, el conector debe confirmar el efecto en destino o conservar de forma durable el trabajo pendiente en un outbox/DLQ con versión, clave de idempotencia, retry acotado y estado observable. Después debe reconciliar periódicamente por employeeNumber y probar que una cuenta suspendida no puede iniciar una nueva sesión en el proveedor. También debe decidir qué ocurre con sesiones existentes, supportTier local y recuperación tras una caída. La prueba negativa debe guardar timestamps, identificadores sintéticos, respuesta del destino y decisión del consumidor; una consulta LDAP negativa sólo demuestra ausencia en esa vista y no sustituye la prueba del consumidor. No necesita almacenar contraseñas ni tokens completos.
Errores frecuentes y límites del modelo
“El DN es la identidad”. El DN ubica una entrada; puede cambiar con un rename o movimiento. La correlación debe usar el identificador que el contrato declara estable.
“Bind correcto significa permiso total”. Bind autentica bajo un mecanismo. Cada operación y cada atributo siguen sus controles y su política.
“Cero resultados significa que la entrada no existe”. El filtro, scope, paginación, réplica, visibilidad y tiempo de consulta pueden explicar la ausencia observada.
“Checkpoint avanzado significa sincronización completada”. El checkpoint debe estar ligado al efecto confirmado en el destino o a la conservación durable del pendiente en outbox/DLQ, según el contrato y el alcance que el sistema promete.
“Última escritura gana siempre”. La resolución de conflictos es una política con supuestos sobre versiones, relojes, orden y autoridad; debe estar declarada.
“Desactivar en la fuente revoca todo”. El efecto sobre cachés, sesiones, tokens, grupos y consumidores depende de sus contratos de refresco y revocación.
“LDAP es AD DS, o LDAP es OAuth”. LDAP define un protocolo/modelo de directorio; AD DS añade semántica de plataforma; OAuth 2.0 delega autorización entre componentes distintos. Sus fronteras importan.
Criterio de diseño y evidencia
Diseñar una integración de identidad segura empieza por declarar la autoridad por atributo, los identificadores de correlación y los estados de ciclo de vida. Continúa con un protocolo de cambios que sea auditable: cursor, versión, actor, transformación, resultado, retry y cuarentena. Termina con un consumidor que tenga una respuesta explícita ante lag, error, ausencia, conflicto y estado desconocido.
Un tablero de “sincronización saludable” debe poder responder qué se verificó y qué no. La métrica de eventos procesados no sustituye la prueba de que el usuario correcto cambió en el destino. La latencia p95 no demuestra ausencia de casos atascados. El número de bajas no demuestra deprovisioning si no se comprueba el consumidor.
La evidencia debe ser proporcional y sintética. Conserva identificadores de prueba, hashes o referencias de eventos, versiones y timestamps; evita registrar contraseñas, secretos SASL, tokens de aplicaciones o respuestas completas que expongan atributos innecesarios. Un resultado negativo puede ser fuerte si declara el alcance: “no se encontró una entrada activa en el consumidor X a las 14:05 bajo el filtro Y” es más útil que “la cuenta fue revocada en todo el ecosistema”.
Síntesis
LDAP ofrece un protocolo para operar sobre un directorio estructurado. DIT, DN, RDN, atributos y schema permiten nombrar y validar entradas, pero no convierten un nombre en una identidad inmutable. Bind establece un contexto; cada search o modify todavía depende de autorización, alcance, controles y estado del servidor.
La sincronización es un proceso distribuido implementado mediante mecanismos y protocolos concretos: correlaciona identidades, transforma atributos, avanza estado incremental y materializa efectos en destinos. Reintentos, paginación, lag, conflictos y deprovisioning exigen idempotencia, versiones, cuarentena y evidencia. La fuente, el conector, el destino y el consumidor pueden mostrar estados diferentes sin que una sola vista explique la realidad completa.
El modelo profesional separa observación, inferencia, impacto posible y decisión. También separa LDAP core de LDAP Content Sync, las extensiones de producto como syncrepl y DirSync, y el provisioning SCIM de un login o una sesión. A su vez, mantiene las fronteras con AD DS, Kerberos y OAuth 2.0. Cuando esas fronteras y precondiciones quedan visibles, una integración puede conservar el trabajo legítimo sin convertir la sincronización en una garantía ficticia.
Comprobación de comprensión
- ¿Qué diferencia hay entre DN, RDN, identificador de correlación y estado de una entrada?
- ¿Qué demuestra un bind correcto y qué debe comprobarse todavía para aceptar un
Modify? - ¿Cómo pueden scope, filtro, paginación y réplica explicar un
Searchsin resultados? - ¿Qué diferencia existe entre una operación idempotente y un reintento que sólo espera ser seguro?
- ¿Qué estados debe conservar un sincronizador antes de avanzar su cursor?
- ¿Cómo adjudicarías un conflicto entre dos escritores sin presentar “última escritura” como ley universal?
- ¿Qué prueba negativa necesitas para afirmar que un deprovisioning llegó al consumidor?
- ¿Por qué TLS o SASL no equivalen a autorización de negocio?
- ¿Cómo distinguirías lag de fuente, error de conector, caché de destino y sesión antigua?
- ¿Qué evidencia permitiría afirmar una sincronización concreta sin afirmar que todo el ecosistema converge?
Problema de transferencia
Northstar suspende a una persona en el directorio de Recursos Humanos, pero el proveedor de soporte sigue aceptando nuevas sesiones. El conector dice que el watermark está actualizado y el log de destino registra un error de tamaño. Reconstruye la línea temporal, identifica qué afirmaciones están observadas y cuáles son inferencias, diseña una remediación idempotente y define una prueba negativa que no exponga credenciales ni tokens.
Fuentes principales
- IETF. RFC 4511: Lightweight Directory Access Protocol (LDAP): The Protocol.
- IETF. RFC 4512: LDAP: Directory Information Models.
- IETF. RFC 4513: LDAP Authentication Methods and Security Mechanisms.
- IETF. RFC 2696: LDAP Control Extension for Simple Paged Results Manipulation.
- IETF. RFC 4533: LDAP Content Synchronization Operation — Experimental.
- OpenLDAP Project. OpenLDAP Administrator’s Guide 2.5: Replication.
- Microsoft Learn. Polling for Changes Using the DirSync Control y Polling for Changes Using USNChanged.
- IETF. RFC 7642: SCIM Definitions, Overview, Concepts, and Requirements, RFC 7643: Core Schema y RFC 7644: Protocol.