«Seguro» no es una propiedad sin condiciones
Una empresa anuncia que su aplicación es segura. Un proveedor afirma que su dispositivo no puede ser vulnerado. Un informe concluye que una red está protegida porque una prueba no encontró fallos críticos. Las tres frases parecen comunicar algo importante, pero ninguna permite todavía saber qué se protege, frente a qué, durante qué operaciones ni con qué evidencia.
En seguridad profesional, la palabra seguro no funciona como una etiqueta absoluta. Describe una relación entre un sistema, propiedades que deben preservarse, condiciones capaces de causar pérdida y fundamentos para confiar en que esas propiedades se mantendrán. Cambiar cualquiera de esos elementos puede volver falsa una afirmación que antes era razonable.
Este capítulo no ofrece una definición mágica que resuelva toda evaluación. Enseña algo más útil: cómo transformar «el sistema es seguro» en una afirmación limitada, discutible y comprobable. Esa disciplina será la base para hablar después de riesgo, evidencia, controles, vulnerabilidades, arquitectura y operaciones sin atribuirles más de lo que realmente demuestran.
Comenzar por la pérdida, no por la tecnología
Una formulación de NIST describe seguridad como libertad frente a condiciones capaces de causar pérdidas de activos con consecuencias inaceptables. La definición evita empezar por productos o ataques famosos. Obliga primero a preguntar qué pérdida importa y para quién. NIST, glosario de Security
En un hospital, alterar la asociación entre una dosis y un paciente puede ser más grave que revelar temporalmente una agenda. En un servicio público de emergencias, la disponibilidad durante una crisis puede dominar otras propiedades. En un repositorio de software, preservar la procedencia e integridad de una versión publicada puede ser decisivo aunque el código sea público.
Confidencialidad, integridad y disponibilidad son una taxonomía útil, pero no sustituyen el análisis. También pueden importar autenticidad, accountability, privacidad, safety, resiliencia o control sobre el uso. Decir «protegemos la integridad» sigue incompleto: ¿integridad de qué objeto, respecto de qué operación y bajo qué autoridad para modificarlo?
El capítulo siguiente desarrollará activos, amenazas, vulnerabilidades y riesgo. Por ahora basta una regla: una propiedad de seguridad adquiere significado cuando se vincula con un activo, una consecuencia y un contexto operativo.
Anatomía de una afirmación defendible
Una afirmación de seguridad —un security claim— necesita hacer explícitos varios componentes:
- sistema y versión: qué producto, servicio, configuración y estado se evalúan;
- frontera: qué componentes se incluyen y cuáles pertenecen al entorno;
- misión: qué debe lograr el sistema y qué usos son relevantes;
- stakeholders y activos: quién puede sufrir la pérdida y qué se valora;
- propiedades: qué debe preservarse y con qué criterio observable;
- condiciones adversas: errores, fallos, accidentes o capacidades de adversarios consideradas;
- fases: diseño, provisión, operación, actualización, recuperación y retiro incluidos;
- umbral: qué consecuencias o degradaciones se consideran inaceptables;
- evidencia: por qué debería creerse la afirmación;
- limitaciones: casos, dependencias e incertidumbres fuera de alcance.
Desliza horizontalmente para leer el diagrama a tamaño completo.
Puede usarse la siguiente plantilla para inspeccionar una frase, no como formulario obligatorio:
Para la versión V del sistema S, operando en el entorno E y durante las fases L, la evidencia Q permite confiar, con las limitaciones U, en que se preserva la propiedad P del activo A frente a la clase de condiciones C, manteniendo las consecuencias dentro del umbral T.
Una frase natural puede expresar lo mismo con menos símbolos. Lo importante es que cada referente exista. Si no sabemos cuál es la versión, «el sistema» puede cambiar después de la evaluación. Si no conocemos el entorno, una dependencia externa puede invalidar el resultado. Si el adversario se describe sólo como «hacker», no sabemos qué acceso, recursos, conocimiento o persistencia se contemplaron.
Caso conductor: «mensajería segura porque usa cifrado de extremo a extremo»
La afirmación contiene una propiedad plausible, pero salta del mecanismo al sistema completo. Para acotarla debemos preguntar:
- ¿cuáles son los extremos: dispositivos, procesos o personas?
- ¿se protege el contenido en tránsito, almacenado, en backups y en notificaciones?
- ¿qué metadatos siguen visibles para el proveedor o la red?
- ¿cómo verifican los usuarios la identidad de sus interlocutores?
- ¿qué ocurre al agregar un dispositivo o recuperar una cuenta?
- ¿se incluyen disponibilidad, abuso por un interlocutor y dispositivos comprometidos?
- ¿qué versión del cliente y del protocolo fue evaluada?
Después de responder, un claim posible sería: «En la versión evaluada, el protocolo protege el contenido de mensajes en tránsito frente a un observador de red que no controla los dispositivos ni las claves, siempre que los usuarios establezcan correctamente la identidad de los extremos». Esta frase es menos espectacular que «imposible de hackear», pero es técnicamente útil. Declara una propiedad, un activo, un adversario y condiciones que pueden ponerse a prueba.
El nuevo claim tampoco prueba por sí solo que la aplicación lo cumpla. El protocolo puede ser correcto y la implementación filtrar texto mediante logs; el cliente puede mostrar una identidad incorrecta; el sistema de recuperación puede introducir otro extremo; o un backup puede conservar contenido sin la misma protección. La seguridad del mecanismo contribuye a la del sistema sólo cuando la composición preserva sus supuestos.
La frontera decide qué preguntas aparecen
Un componente criptográfico puede satisfacer su especificación mientras el producto lo usa mal. El producto puede funcionar correctamente y el servicio desplegarlo con configuración insegura. El servicio puede resistir ataques técnicos y la organización entregar sesiones mediante un proceso de soporte débil. No hay contradicción: se están evaluando sistemas diferentes.
Desliza horizontalmente para leer el diagrama a tamaño completo.
Definir una frontera no significa ignorar lo externo. Significa distinguir elementos bajo diseño directo de dependencias y condiciones ambientales. Electricidad, DNS, autoridades certificadoras, proveedores cloud, operadores, dispositivos cliente y procesos legales pueden quedar fuera de un componente, pero dentro del argumento que permite confiar en el servicio.
Las fronteras también cambian con el ciclo de vida. Durante fabricación importan herramientas, artefactos y cadena de suministro. En provisión aparecen identidades iniciales y secretos. En operación, telemetría y administración. En recuperación, backups y autoridades de emergencia. En retiro, revocación y eliminación de datos. «Era seguro al salir de fábrica» no responde qué ocurre después de años de actualizaciones y cambios de dependencia.
Las garantías no se suman mecánicamente
Los sistemas reales se construyen con componentes que ofrecen claims distintos. Una base de datos puede garantizar atomicidad para ciertas transacciones; un protocolo puede autenticar un canal; un módulo hardware puede impedir exportar una clave; y un sistema operativo puede aislar procesos bajo una política. Aunque cada afirmación sea cierta, su composición puede no producir la propiedad final.
Los supuestos deben encajar. Si el protocolo autentica un nombre pero la aplicación espera una identidad diferente, la verificación correcta no resuelve la necesidad. Si el módulo protege una clave pero permite que cualquier proceso autorizado solicite firmas arbitrarias, la no exportabilidad no impide abuso. Si la base de datos conserva integridad transaccional pero la aplicación calcula una transferencia incorrecta antes de escribirla, almacenará fielmente el resultado equivocado.
La composición exige localizar interfaces y autoridades: quién traduce identidades, quién decide la política, qué datos cruzan la frontera y qué ocurre cuando un componente falla. También requiere observar propiedades emergentes. Dos servicios disponibles por separado pueden depender del mismo proveedor y fallar juntos; dos controles independientes en el diagrama pueden compartir la misma credencial administrativa.
Por eso la evidencia de componentes se reutiliza, pero no se extrapola. Sirve como premisa dentro de un argumento más amplio. El argumento del sistema debe demostrar que las precondiciones se satisfacen, que las interfaces preservan significado y que ninguna ruta relevante elude la propiedad. Esta idea aparecerá repetidamente en autenticación, criptografía, supply chain, cloud y arquitectura: una garantía sólo viaja a través de una composición que conserva sus supuestos.
Seguridad no equivale a ausencia de fallos observados
No encontrar una vulnerabilidad en una evaluación significa que ciertos procedimientos, personas y herramientas no demostraron una vulnerabilidad dentro de un alcance y tiempo. No prueba que ninguna exista. La diferencia parece obvia, pero informes y decisiones la borran con frecuencia.
Una prueba de penetración aporta evidencia empírica sobre caminos explorados. Una revisión de código puede descubrir clases de defectos y razonar sobre flujos ausentes de una ejecución. Un análisis formal puede probar una propiedad de un modelo bajo supuestos explícitos. La observación operacional muestra comportamiento del despliegue real, aunque sólo para estados y condiciones observados. Estas fuentes se complementan; ninguna produce por sí sola una garantía ilimitada.
La evidencia negativa requiere especial cuidado. «No hubo accesos no autorizados» podría significar que no ocurrieron, que no fueron observables, que los registros se perdieron o que nadie los revisó. El capítulo 6 estudiará incertidumbre y resultados negativos. Aquí basta mantener la dirección lógica: ausencia de evidencia no es automáticamente evidencia de ausencia, aunque en un sistema con observabilidad y pruebas adecuadas sí puede actualizar razonablemente nuestra confianza.
Trust no es lo mismo que trustworthiness
Confiar es decidir depender de una entidad pese a la posibilidad de daño. Trustworthiness describe el fundamento o capacidad demostrada para merecer esa dependencia respecto de requisitos definidos. SP 800-160 relaciona esta noción con propiedades como security, safety, resilience, reliability y survivability; no presenta esa lista como una taxonomía exhaustiva de privacidad. NIST, Engineering Trustworthy Secure Systems
La diferencia importa porque una arquitectura puede depositar mucha confianza en un componente con poca evidencia. Un servicio central de identidad quizá pueda modificar permisos de toda la organización. Esa autoridad expresa confianza estructural; no demuestra que el servicio sea digno de ella. Reducir privilegio disminuye la confianza necesaria. Mejorar diseño, verificación y operación aumenta fundamentos para confiar. Son estrategias distintas y complementarias.
Tampoco debe invertirse la relación: un componente puede ser trustworthy dentro de su especificación y no merecer confianza para otro propósito. Una biblioteca diseñada para preservar integridad de mensajes no adquiere por ello disponibilidad, almacenamiento seguro ni políticas correctas de autorización.
Assurance: razones para creer, no sensación de seguridad
Assurance es la confianza justificada de que ciertos claims son verdaderos. La palabra «justificada» separa assurance de optimismo. Requiere trazabilidad entre necesidades, requisitos, arquitectura, implementación, evaluación y evidencia operacional.
La fuerza necesaria depende de las consecuencias. Para una página informativa puede bastar una combinación modesta de revisión, pruebas y monitorización. Un sistema capaz de afectar vidas, infraestructura o autoridad masiva exige independencia, profundidad y cobertura mayores. Esto no convierte assurance en una cifra universal: obliga a relacionar rigor y consecuencias.
Desliza horizontalmente para leer el diagrama a tamaño completo.
NIST SP 800-53A ofrece procedimientos adaptables para evaluar controles, pero evaluar un control no es sinónimo de probar toda propiedad del sistema. NIST SP 800-53A Rev. 5 Una configuración puede estar presente y no ser efectiva ante la condición relevante; un control puede operar bien y el claim fallar por otra ruta. La evaluación debe conservar el vínculo entre objetivo, método, evidencia y conclusión.
Control, cumplimiento y propiedad
Un control es una medida destinada a modificar riesgo o sostener requisitos. El cifrado, el aislamiento, una revisión por pares y un proceso de recuperación pueden ser controles. Su existencia no demuestra automáticamente el resultado.
El cumplimiento verifica correspondencia con obligaciones o criterios definidos. Es valioso: crea lenguaje común, mínimos, responsabilidad y evidencia repetible. Pero un baseline se diseña para una clase de contextos. Puede omitir una amenaza específica, aplicarse de manera superficial o quedar desactualizado. «Cumple» responde qué criterios fueron evaluados; «es seguro» necesitaría además demostrar que esos criterios cubren las pérdidas y condiciones relevantes.
La dirección correcta va de necesidades de protección a claims, requisitos, diseño, controles y evaluación. Empezar por una lista de controles y suponer que el resultado será seguridad invierte el razonamiento.
Verificación y validación
La verificación pregunta si el sistema satisface los requisitos especificados. La validación pregunta si el sistema y esos requisitos resuelven la necesidad real en su entorno. Podemos verificar perfectamente el requisito equivocado.
Imaginemos que un requisito exige bloquear una cuenta tras cinco intentos fallidos. La implementación puede cumplirlo exactamente. Sin embargo, si un adversario puede bloquear miles de usuarios intencionalmente, la política quizá perjudique disponibilidad. La verificación confirma la regla; la validación examina si la regla sostiene la misión frente a las condiciones reales.
Ambas dependen del alcance. Probar el binario no valida el proceso de actualización. Probar la API no verifica el cliente móvil. Revisar la versión 4.2 no aporta automáticamente evidencia para la 4.3. Una conclusión profesional conserva esa granularidad.
Del mecanismo al impacto: cómo no saltarse la causalidad
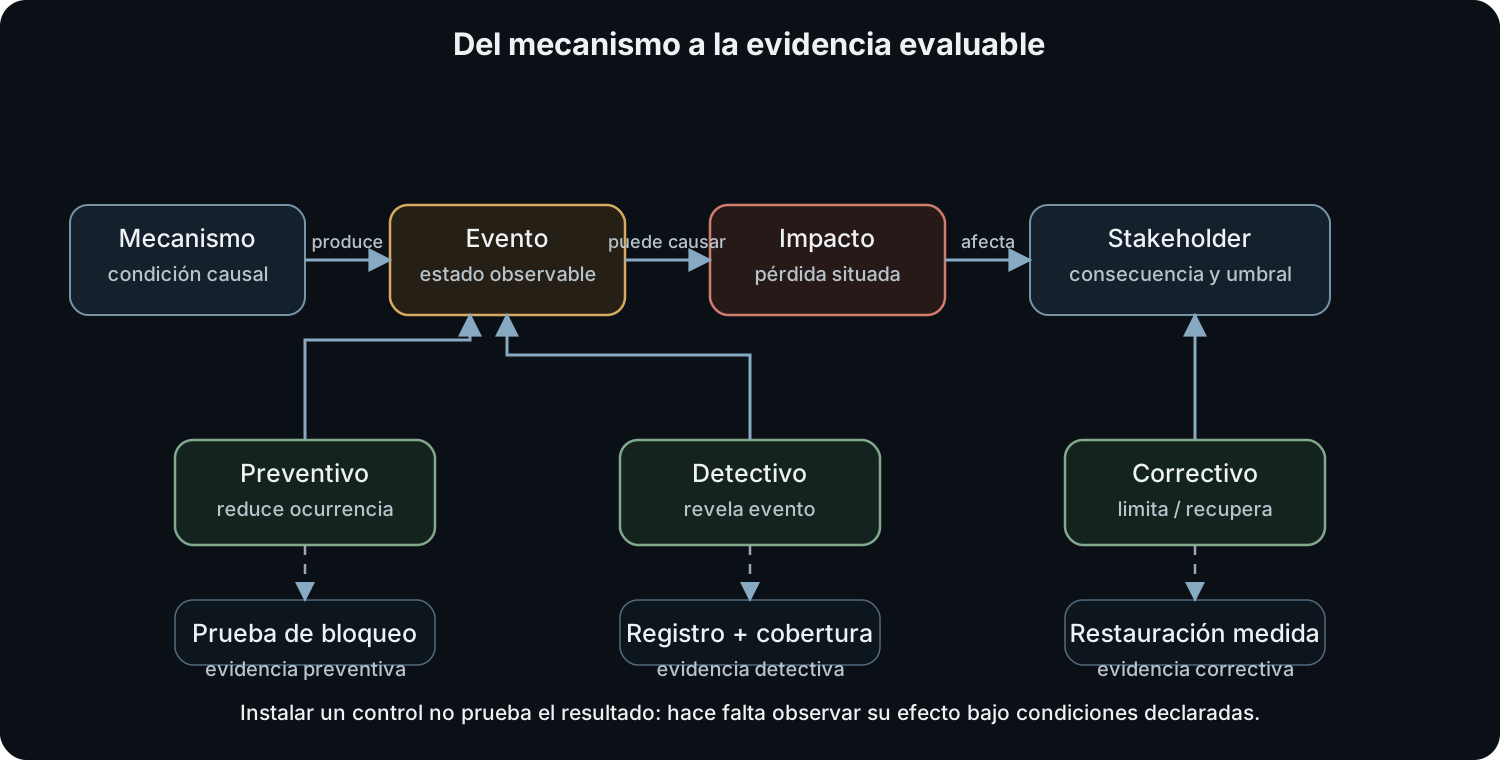
Una revisión madura no pregunta solamente si existe un control. Reconstruye el camino por el que una condición podría producir una pérdida y ubica el control en ese camino. El orden importa. Un mecanismo describe una capacidad o condición —por ejemplo, una credencial reutilizable o una dependencia que acepta cambios sin verificación—; un evento es lo que ocurre cuando se satisfacen sus precondiciones; el impacto conecta ese evento con un activo y una consecuencia; el control intenta prevenir, detectar o recuperar; la evidencia permite saber si el control estuvo presente y operó como se esperaba.
Supongamos que un servicio permite cambiar la dirección de entrega de una orden. El mecanismo relevante no es «la API tiene autenticación», sino que una solicitud autenticada puede llegar a la operación y que el receptor no vincula el cambio con el propietario de la orden. El evento sería una modificación aceptada para una orden ajena; el impacto podría ser pérdida económica o exposición de una dirección; un control preventivo podría exigir autorización por recurso; uno detectivo podría registrar el actor, orden y decisión; uno correctivo podría congelar la orden y revertir el cambio. Cada control tiene una pregunta distinta. Un log que existe pero no se consulta no demuestra detección operativa; una regla de autorización que nunca se prueba no demuestra cobertura de todos los caminos.
Desliza horizontalmente para leer el diagrama a tamaño completo.
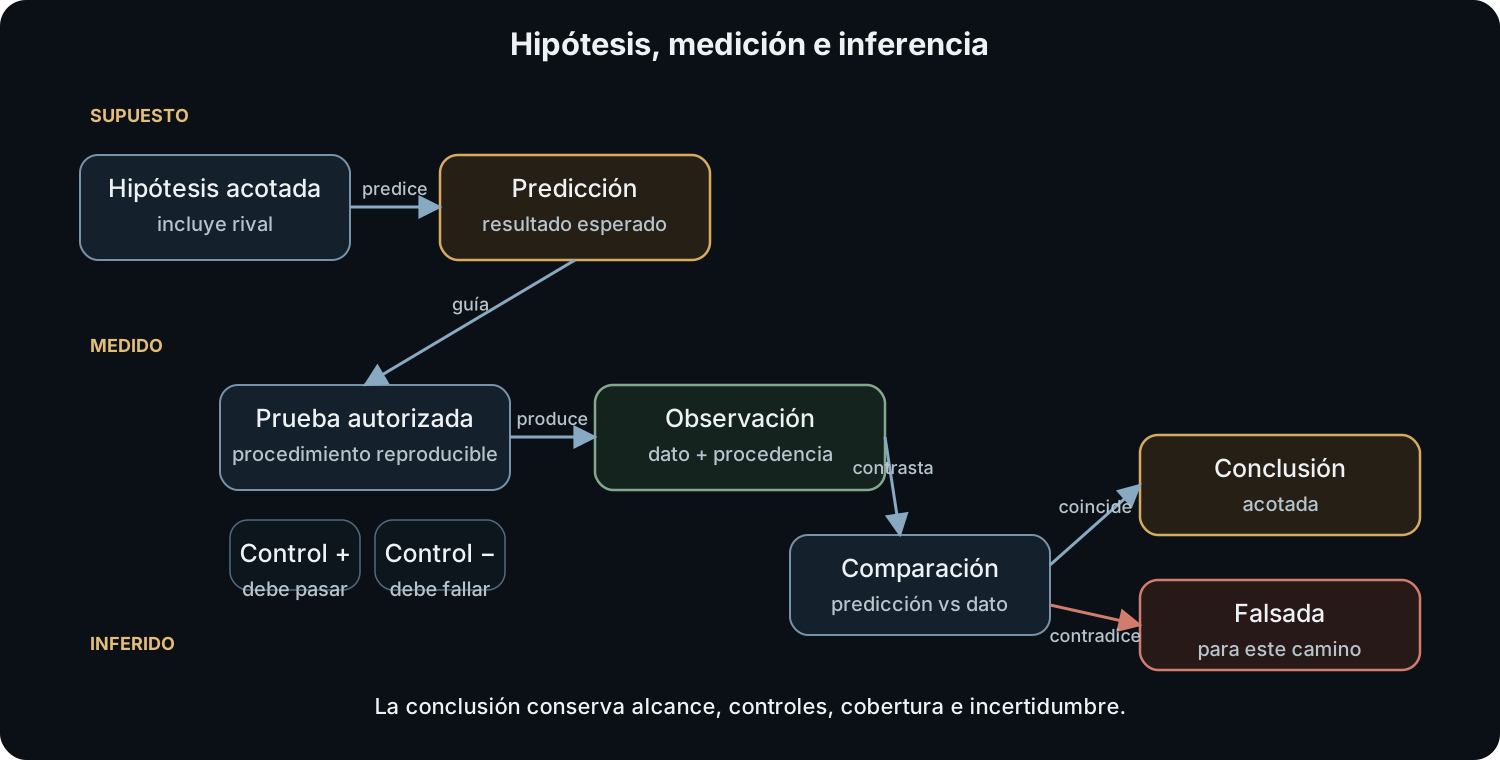
La figura resume una disciplina transferible. Primero se formula una hipótesis con alcance: «para esta versión, una solicitud sin autorización por recurso será rechazada». Después se deriva una predicción observable: una petición sintética con identidad válida pero recurso ajeno debe producir una decisión de denegación y un registro no reutilizable. Se define una prueba autorizada, un control positivo que debería pasar y un control negativo que debería fallar. La observación se compara con la predicción. Si el control negativo es aceptado, la hipótesis queda falsada para ese camino; si es rechazado, aumenta la confianza en ese comportamiento, pero no se prueba que todos los caminos sean equivalentes.
Esta forma de razonar separa cuatro capas que suelen comprimirse en un informe. La observación es «el endpoint devolvió 403 en la prueba T, con configuración C». La inferencia es «la policy evaluó esa combinación de principal y recurso». El impacto posible es «una ruta no probada podría permitir modificación si omite el mismo punto de enforcement». La decisión es «mantener la publicación, ampliar pruebas o abrir un hallazgo». Mezclarlas produce conclusiones que parecen contundentes pero no pueden auditarse.
La superficie de ataque no es una lista de herramientas
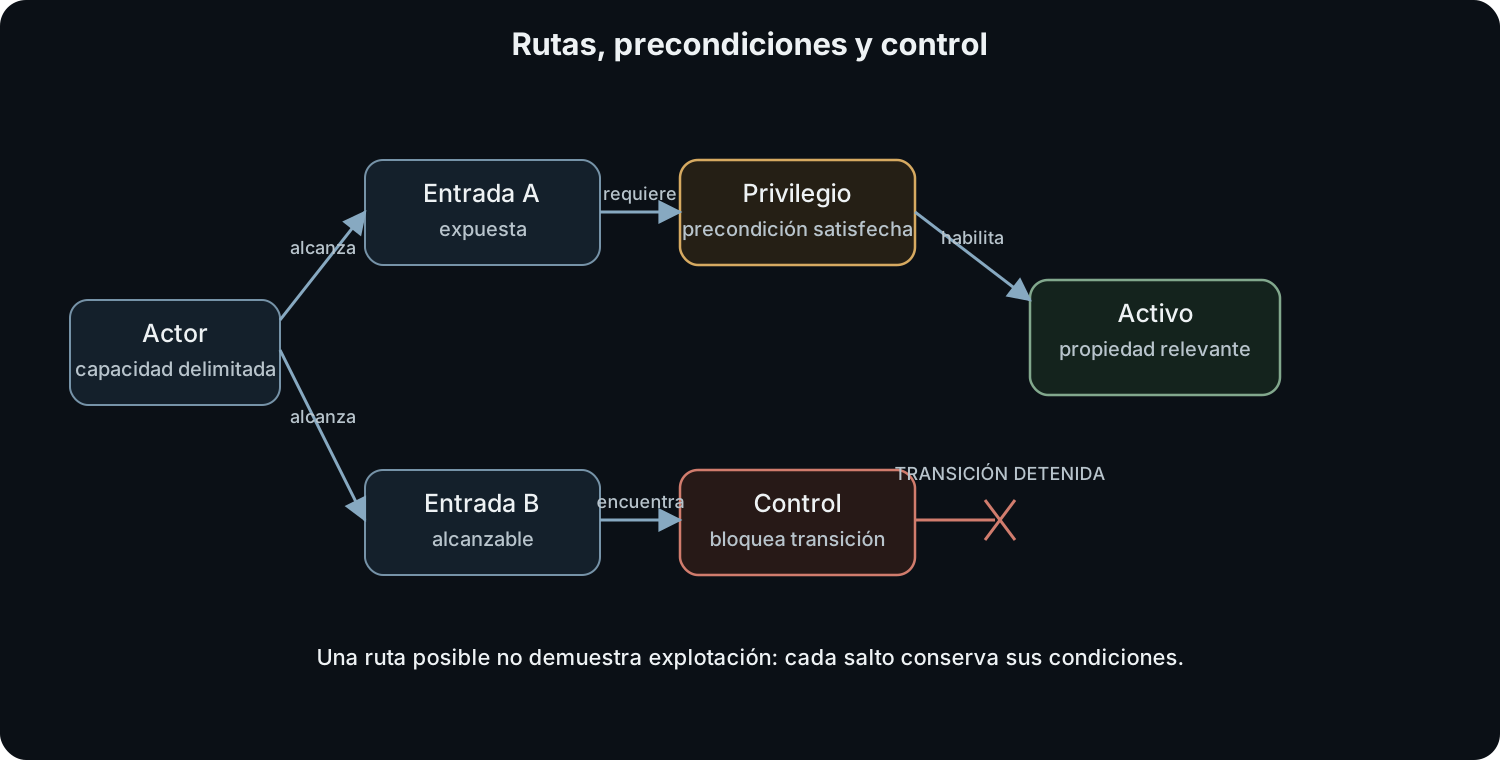
Una superficie de ataque es el conjunto de puntos y rutas por los que una condición adversa puede interactuar con el sistema, junto con las precondiciones que hacen posible cada transición. Un puerto abierto es una exposición; no es por sí solo una vulnerabilidad explotable. Una vulnerabilidad es una condición del diseño, implementación, configuración u operación que puede ser explotada bajo determinadas precondiciones. El riesgo aparece cuando ese escenario se combina con incertidumbre, impacto y contexto. Mantener las palabras separadas evita inflar un inventario hasta convertirlo en una conclusión.
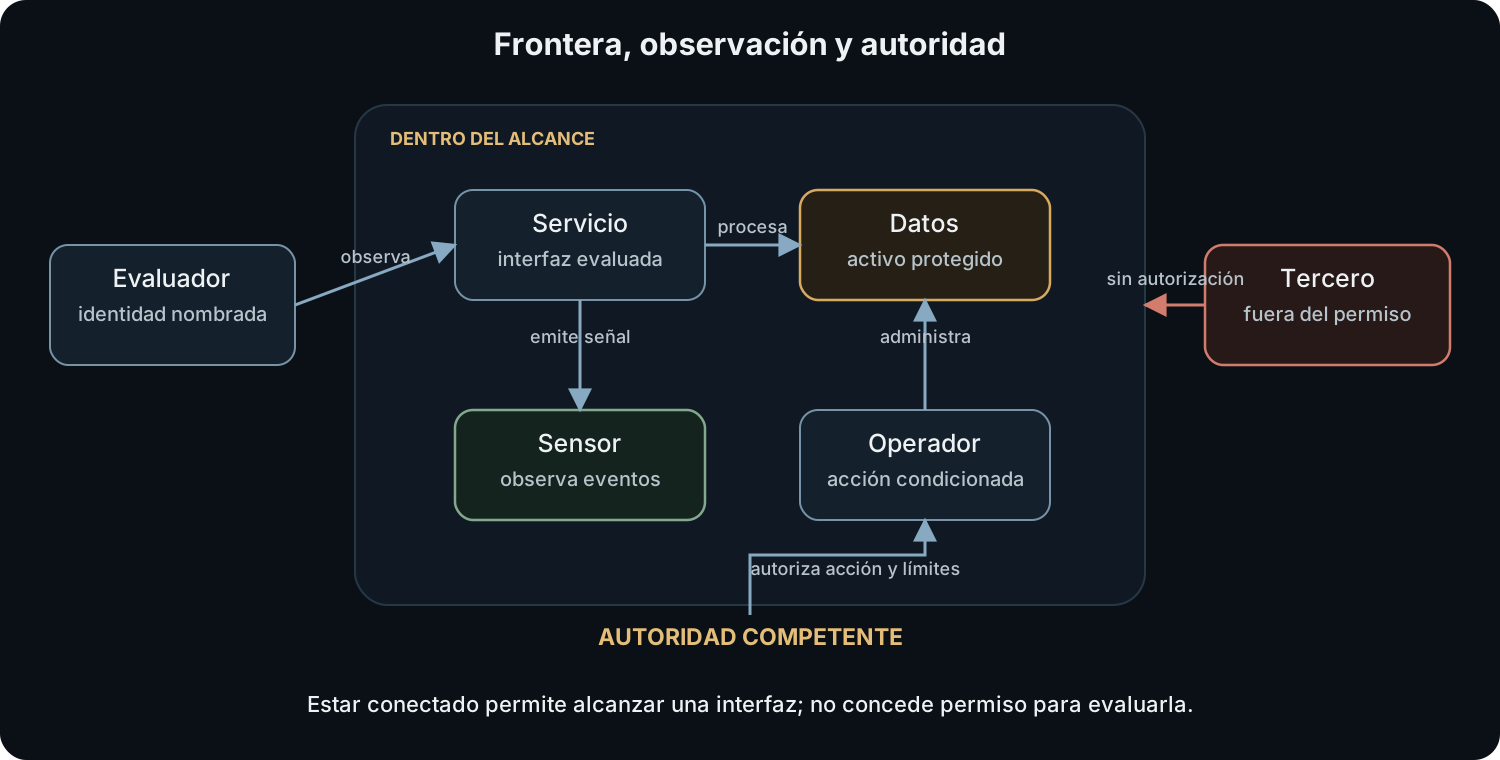
En un servicio de facturación, una ruta puede comenzar en una aplicación móvil, atravesar un gateway, alcanzar una API y terminar en un registro de factura. Cada salto tiene una autoridad y una condición: el gateway debe enrutar, la API debe identificar el principal, el servicio debe comprobar el tenant y la base de datos debe limitar la operación. Un control puede bloquear la ruta en el gateway, pero otra ruta administrativa puede entrar por un canal distinto. Por eso un diagrama útil etiqueta la relación —flujo de datos, confianza, administración o decisión— y muestra tanto una ruta habilitada como una ruta bloqueada. No debe insinuar que una flecha equivale a una explotación reproducida.
La autorización del análisis también forma parte del modelo. Un sensor que observa tráfico de una red no adquiere permiso para modificarlo; un equipo de respuesta que puede contener un host no debe hacerlo sólo porque detectó una señal. El alcance técnico y la autoridad operativa deben estar escritos antes de medir. Sin ese límite, incluso una prueba bien intencionada puede convertirse en un incidente o invalidar la evidencia.
Caso conductor, segunda vuelta: actualizar el claim cuando cambian las premisas
Volvamos a la mensajería. El primer claim acotaba contenido en tránsito frente a un observador de red, bajo la condición de que los extremos y sus claves fueran correctos. Ahora aparece evidencia nueva: el proveedor conserva backups legibles durante treinta días. La afirmación sobre tránsito puede seguir siendo válida en su alcance original; ya no sostiene una afirmación sobre confidencialidad del contenido durante todo el ciclo de vida. No se debe declarar que «el cifrado falló» si el mecanismo protegido no incluía backups. Se debe ampliar o dividir el claim.
Un claim nuevo podría decir: «Para el backup de la versión evaluada, el contenido se cifra con una clave gestionada por el servicio y el acceso queda limitado a una policy de recuperación; la evidencia disponible cubre configuración y pruebas de restauración, pero no demuestra que un operador con autoridad administrativa no pueda leerlo». La conclusión útil no es binaria. Identifica qué propiedad conserva el sistema, qué nueva frontera importa y qué evidencia falta.
La misma actualización ocurre si un cliente está comprometido, si las notificaciones muestran texto, si la recuperación de cuenta permite registrar otro dispositivo o si los metadatos permanecen visibles. Cada cambio altera una premisa distinta: extremo confiable, canal de presentación, autoridad de identidad, almacenamiento o privacidad contextual. El caso enseña una regla general: cuando cambia una precondición, se reevalúa el claim afectado; no se conserva la conclusión por inercia ni se descarta sin analizar qué parte sí permanece.
Señales, evidencia e incertidumbre
Una señal es una observación que merece atención; un indicador es una representación que ayuda a clasificar o buscar; evidencia es una señal contextualizada, con procedencia, integridad, tiempo, método y una relación explícita con la pregunta. La misma línea de log puede ser útil para depurar y débil para atribuir causa. Un resultado de scanner puede orientar una investigación, pero un hallazgo profesional necesita confirmar versión, ruta, precondiciones, control positivo y consecuencia posible.
Desliza horizontalmente para leer el diagrama a tamaño completo.
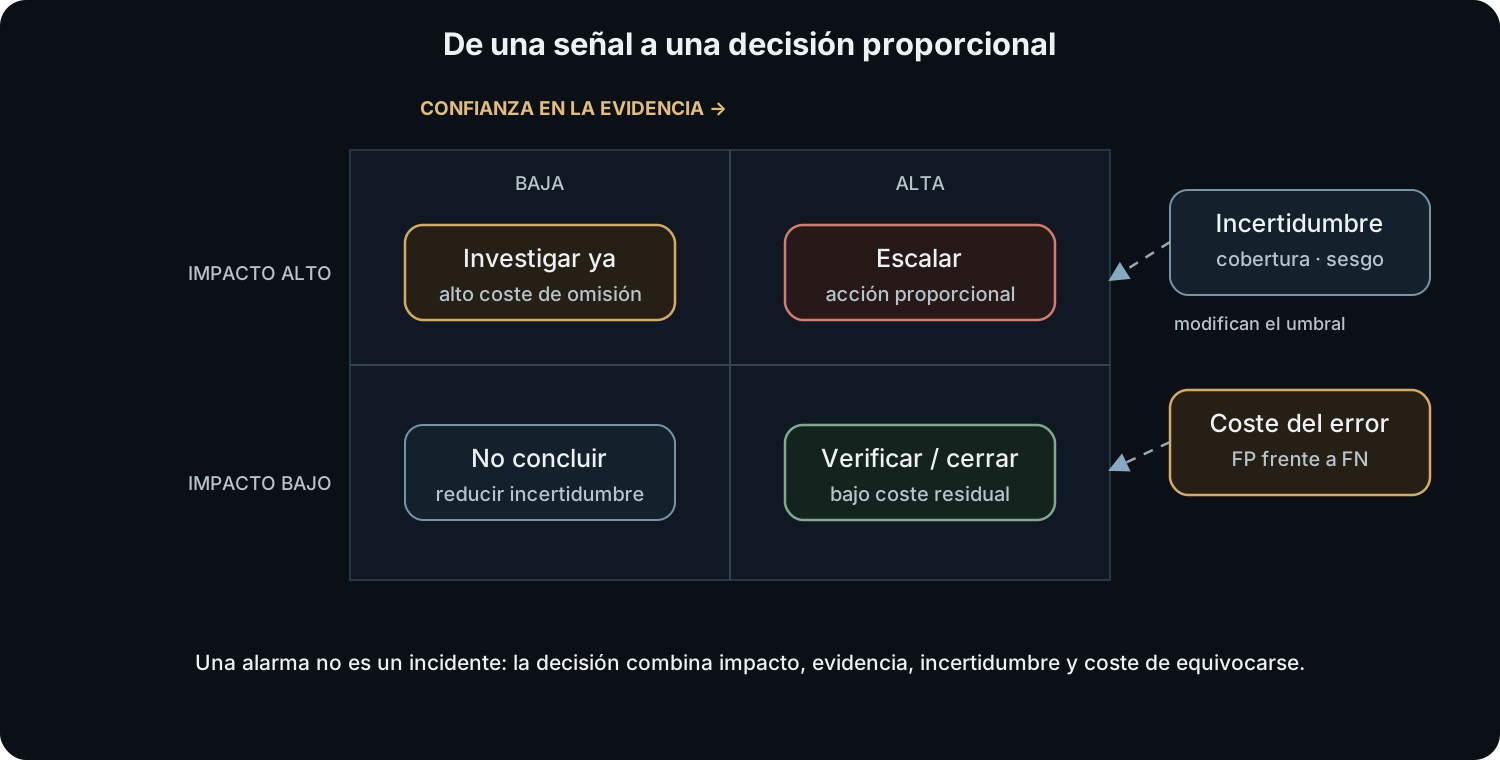
La matriz no es una fórmula universal. Su propósito es impedir que confianza e impacto se confundan. Una señal de alta confianza y bajo impacto puede cerrarse con registro; una señal de baja confianza y alto impacto puede justificar una investigación rápida sin afirmar que el incidente existe; una señal de alta confianza y alto impacto puede requerir contención autorizada. Un falso positivo consume tiempo y puede interrumpir un servicio; un falso negativo puede dejar una pérdida sin atender. La decisión debe hacer explícito qué error se está evitando y qué evidencia adicional reduciría la incertidumbre.
«No hubo vulnerabilidades críticas» puede significar varias cosas: no se encontraron dentro de una lista de pruebas; no se detectaron durante el periodo; no hubo cobertura de cierto componente; o el criterio de criticidad no incluía una consecuencia relevante. La lectura correcta pide alcance, tiempo, métodos, versiones, controles negativos y excepciones. La ausencia de un registro sólo es informativa si sabemos que el sistema tenía capacidad de observar el fenómeno y que el proceso de revisión se ejecutó.
Frontera, composición y cambio de autoridad
La frontera del claim es una decisión de modelado, no una pared física. Un módulo criptográfico puede estar dentro de un producto y fuera del servicio que lo despliega. Al ampliar de componente a producto se agregan llamadas, serialización, gestión de errores y configuración. Al ampliar a servicio aparecen identidad, operadores, actualizaciones, telemetría, dependencias y continuidad. Al incluir la organización entran soporte, proveedores, procesos de excepción y autoridad legal. Cada salto requiere nuevas premisas y evidencia.
La composición falla cuando una interfaz cambia el significado de una propiedad. Un componente puede autenticar una identidad, mientras que el servicio receptor necesita autorización por recurso; si la traducción omite el recurso, ambos claims locales pueden ser verdaderos y el claim de negocio falso. Una base de datos puede garantizar integridad de una transacción, mientras que la aplicación calcula el importe equivocado antes de escribirlo. Un backup puede ser íntegro y, sin embargo, restaurarse con credenciales vencidas. El argumento final debe señalar quién decide, qué datos cruzan la interfaz, qué supuestos se heredan y qué sucede ante fallo.
Desliza horizontalmente para leer el diagrama a tamaño completo.
La composición también es temporal. Una evidencia de la versión 4.2 no se extiende a 4.3 si cambió el código, la dependencia, la configuración o el trust boundary. Rotar una clave publicada no prueba que conexiones existentes hayan cerrado ni que todos los receptores rechacen el material anterior. Cambiar un proveedor puede modificar disponibilidad, jurisdicción, observabilidad y autoridad. Por eso un claim debe incluir versión y horizonte, y una modificación material debe abrir una reevaluación, aunque la interfaz pública no haya cambiado.
Del hallazgo a una decisión que pueda reabrirse
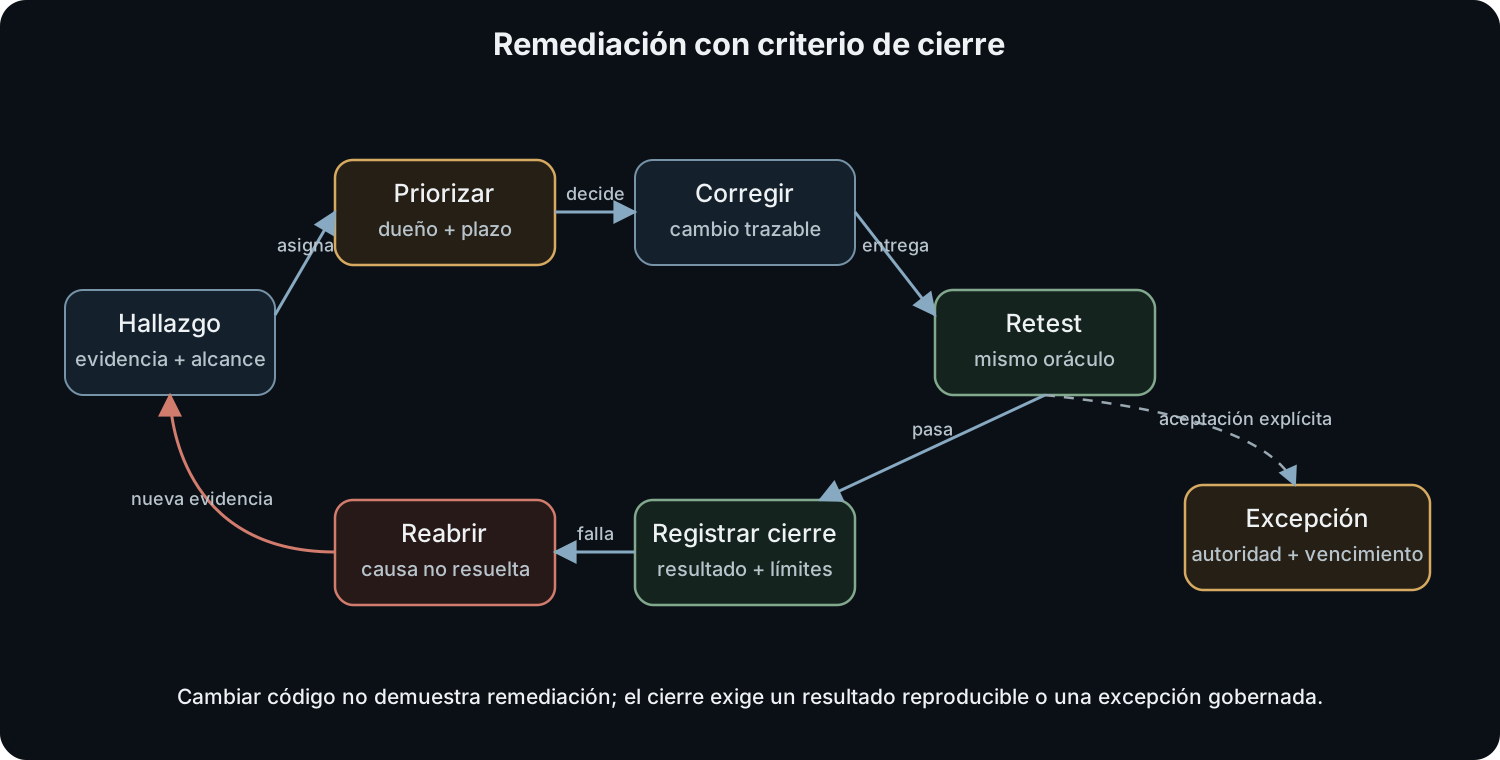
Un hallazgo no es la salida de una herramienta. Es un argumento que conecta evidencia, condición, precondiciones, impacto y decisión. Para cerrarlo hace falta un propietario, una acción, un criterio observable y un retest que pueda fallar. Si el retest falla, el hallazgo se reabre; si pasa, se registra qué camino y qué versión quedaron cubiertos. Una excepción aceptada no borra la condición: conserva quién aceptó, durante cuánto, con qué compensaciones y qué evento obliga a revisarla.
Este bucle evita dos errores opuestos. El primero es declarar remediación porque se cambió una línea, sin probar que la ruta vulnerable ya no funciona y que no apareció una regresión. El segundo es mantener indefinidamente una alarma sin decisión, aunque la evidencia no sostenga el impacto. El lenguaje debe distinguir corregir la causa, reducir la exposición, detectar antes o recuperar mejor. Son mitigaciones diferentes y no deben presentarse como equivalentes.
Un segundo escenario para comprobar transferencia
Considere ahora un pipeline que publica una imagen de contenedor. El equipo afirma: «La imagen es segura porque la firma es válida». La firma puede aportar autenticidad e integridad respecto de una clave y una política de confianza, pero no prueba que el contenido sea libre de vulnerabilidades, que el pipeline no haya sido comprometido antes de firmar, que el registro entregue el digest esperado, que la imagen tenga autorización para producción ni que el runtime aplique aislamiento. El claim debe dividirse.
Una versión acotada sería: «Para el digest D, el verificador acepta la firma S emitida por la identidad I, usando el trust root R y la policy P, en el registro y ventana temporal especificados». La evidencia pertinente incluye digest, firma, cadena o raíz, policy efectiva, reloj, identidad del firmante y decisión del verificador. Un claim separado debe cubrir autorización de despliegue; otro, análisis de dependencias; otro, configuración del runtime. Si la clave de firma fue comprometida, el hecho criptográfico puede seguir siendo cierto y la confianza operacional quedar invalidada. Si el runtime permite privilegio excesivo, la firma no transfiere seguridad al proceso.
El escenario es deliberadamente parecido al de mensajería: en ambos casos un mecanismo legítimo se convierte indebidamente en una propiedad global. La transferencia consiste en encontrar el activo, la operación, la autoridad, la frontera, las precondiciones y la evidencia, incluso cuando cambian tecnología y vocabulario.
Adversarios y condiciones sin extremos inútiles
Un modelo adversarial no necesita predecir cada atacante. Delimita capacidades relevantes: posición de red, credenciales, acceso físico, tiempo, conocimiento interno, presupuesto, posibilidad de comprometer dependencias o colaborar con otros. Esto permite diseñar y evaluar.
Suponer un adversario omnipotente vuelve imposible todo claim: si controla cada dispositivo, operador y evidencia, ningún mecanismo conserva significado. Suponer sólo un atacante torpe produce confianza artificial. El modelo debe ser exigente respecto de las pérdidas relevantes y honesto sobre capacidades fuera de alcance.
Además, no todas las condiciones adversas tienen intención. Defectos, errores operativos, agotamiento de recursos, fallos de energía y dependencia pueden causar las mismas pérdidas. Systems security engineering integra estas condiciones con la misión y el ciclo de vida, en lugar de reducir seguridad a detener intrusiones.
Seguridad y resiliencia
Prevenir todo fallo o compromiso no siempre es posible. La resiliencia amplía el argumento: anticipar, resistir, recuperarse y adaptarse ante condiciones adversas, ataques o compromiso. NIST SP 800-160 Vol. 2 Rev. 1
Esto no abandona la prevención. Reconoce que un sistema puede necesitar mantener funciones esenciales, limitar propagación, restaurar un estado confiable y aprender después de que una barrera falle. Un claim de resiliencia debe ser tan concreto como cualquier otro: qué función continúa, con qué degradación, durante cuánto tiempo y bajo qué recursos de recuperación.
Decir «somos resilientes porque tenemos backups» repite el error del cifrado. Importan cobertura, aislamiento, integridad, objetivos de recuperación, dependencias, credenciales y pruebas reales de restauración. El mecanismo es una pieza; la propiedad pertenece al sistema.
Afirmaciones que deben despertar sospecha
«Cien por ciento seguro». No declara condiciones ni reconoce cambio, incertidumbre o límites.
«No puede ser hackeado». No define qué resultado cuenta como compromiso ni qué capacidades se consideran.
«Usa tecnología de grado militar». Apela a una etiqueta sin demostrar adecuación, integración o propiedad.
«Pasó la auditoría». Omite qué auditoría, versión, alcance, criterios, evidencia y excepciones.
«Nunca sufrimos incidentes». Confunde historia observada con garantía futura y puede ignorar capacidad de detección.
«Está aislado». El aislamiento depende de interfaces reales: suministro, medios, mantenimiento, operadores, radio, actualizaciones y cadena de suministro.
Estas frases no son necesariamente falsas; son indeterminadas. La respuesta profesional no es burlarse, sino pedir los referentes que permitirían evaluarlas.
Cómo leer un claim de seguridad
Ante cualquier afirmación, siga este orden:
- Identifique el sistema y la versión exactos.
- Pregunte qué pérdida y qué stakeholder motivan el claim.
- Localice propiedad, activo y operación protegida.
- Trace la frontera y las dependencias ambientales.
- Delimite condiciones accidentales y capacidades adversarias.
- Determine las fases del ciclo de vida cubiertas.
- Examine qué evidencia respalda cada parte.
- Compruebe qué limitaciones y cambios invalidan la conclusión.
Si faltan elementos, el resultado correcto puede ser «no evaluable todavía», no «inseguro». Esta distinción evita reemplazar propaganda con otra afirmación igualmente infundada.
Síntesis
La seguridad no es una sustancia que un producto posea en cantidad absoluta. Es una afirmación sobre preservación de propiedades y pérdidas aceptables en un sistema, entorno y ciclo de vida definidos, frente a condiciones concretas y con evidencia proporcional a las consecuencias.
Un mecanismo no hereda automáticamente su propiedad al producto; una evaluación no se extiende automáticamente a otra versión; un control no prueba por sí solo su objetivo; y cumplimiento no equivale a seguridad universal. Trust describe dependencia. Trustworthiness describe fundamento para merecerla. Assurance reúne razones justificadas para aceptar claims acotados.
Esta forma de hablar puede parecer más prudente, pero también es más poderosa. Permite diseñar requisitos, comparar evidencia, localizar desacuerdos y saber qué cambio obliga a reevaluar. En los próximos capítulos, activos, amenazas, evidencia e incertidumbre completarán ese vocabulario.
Comprobación de comprensión
- ¿Por qué «la aplicación es segura» no constituye todavía un claim técnico?
- ¿Qué diferencia existe entre un mecanismo de seguridad y una propiedad del sistema?
- ¿Cómo cambia la conclusión al ampliar la frontera de componente a servicio?
- ¿Por qué ausencia de hallazgos no demuestra ausencia de vulnerabilidades?
- Distingue trust, trustworthiness y assurance mediante un ejemplo.
- ¿Qué puede demostrar una evaluación de cumplimiento y qué no demuestra por sí sola?
- ¿Cómo pueden divergir verificación y validación?
- ¿Qué elementos añadirías a «nuestros backups hacen resiliente al sistema»?
Problema de transferencia
Un fabricante afirma: «La cerradura inteligente es segura porque el chip criptográfico tiene certificación y nunca se ha reportado una intrusión». Reformula la afirmación como uno o más claims evaluables. Incluye la aplicación móvil, recuperación de cuenta, actualizaciones, energía, acceso físico y servicio cloud sólo cuando correspondan a la frontera elegida. Para cada claim, especifica qué evidencia sería pertinente y qué conclusión seguiría fuera de alcance.
Fuentes principales
- Ron Ross, Mark Winstead y Michael McEvilley. NIST SP 800-160 Vol. 1 Rev. 1: Engineering Trustworthy Secure Systems.
- Ron Ross et al. NIST SP 800-160 Vol. 2 Rev. 1: Developing Cyber-Resilient Systems.
- NIST. SP 800-53A Rev. 5: Assessing Security and Privacy Controls.
- Jerome H. Saltzer y Michael D. Schroeder. The Protection of Information in Computer Systems. Proceedings of the IEEE, 1975.